
Microsoft Translatorが中国語の文芸翻訳をリリース
読むとき 古代 中国語 詩の世界では、古代の作家たちが人や出来事、物や場面を表現するのにとても素晴らしい言葉を使っていたことに驚かされることがあります。これは、私たちに残された素晴らしい文化遺産です。しかし、シェークスピアと同様に’しかし、彼らが使っていた漢語は、現代人には理解しがたく、その意味や微妙なニュアンスが失われていることが多い。
この問題を解決するために、マイクロソフトリサーチアジアの研究者たちは、最新のニューラル機械翻訳技術を採用して、文学的な中国語と現代中国語の間の直接翻訳モデルを学習し、結果的に文学的な中国語と 90以上の他の言語 と方言をMicrosoft Translatorで翻訳しています。現在、中国語の文芸翻訳が組み込まれているのは Microsoft Translator アプリ, Azure Cognitive Services Translatorまた、Microsoft Translatorサービスでサポートされている多くのMicrosoft製品にも対応しています。
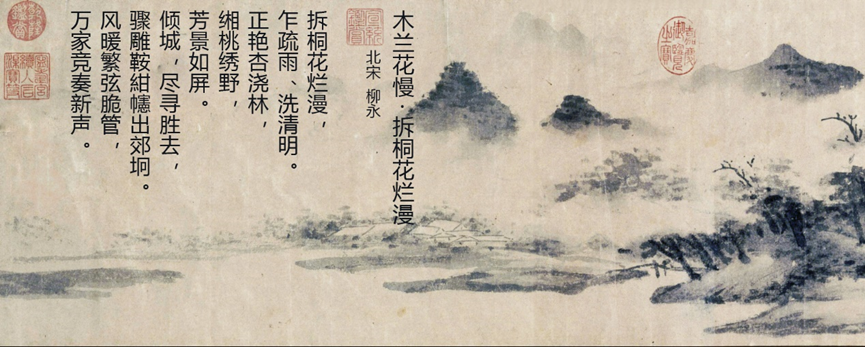
画像を見る明代、神周の「霧雨の西山」の絵。絵に描かれている古代中国の詩は ヨン 劉、北宋時代。この詩は、清明節の中国南部の春の風景と、社会生活の繁栄を描いたものです。
中国の伝統文化の魅力をより多くの方に知っていただくために
文学的な中国語は、中国の伝統文化の重要な担い手です。古くからの膨大な書物や文章は、中国を記録しています。’豊かで深遠な文化は、5,000年の歴史の中で培われてきました。その中に蓄積された思想や知恵は、絶えず探求し、考える価値があります。
機械翻訳のおかげで、観光客は歴史的建造物や記念碑に書かれた中国の古文や詩を理解できるようになり、学生は中国語を学ぶためのツールが増え、古文の照合や翻訳に携わる研究者は生産性が向上します。
マイクロソフトリサーチアジアの主席研究員、Dongdong Zhang氏は、「技術的な観点からは、文語は独立した言語とみなすことができます。文語と現代中国語の翻訳が実現すれば、文語と英語、フランス語、ドイツ語などの他の言語との翻訳は当然のこととなる。"
中国語文芸翻訳AIモデルの最大の難点。学習データが少ない
AIモデルの学習で最も重要な要素はデータです。十分な量のデータと質の高いデータがあって初めて Cna 此方 は、より精度の高いモデルを学習します。機械翻訳では、モデルの学習には原文データと目標言語データの対訳が必要です。文学的な中国語の翻訳は非常に特殊です, として、それをは日常生活で使われる言語ではありません。 そのため、他の言語の翻訳に比べて、文学的な中国語の翻訳のトレーニングデータは非常に少なく、機械翻訳モデルのトレーニングには適していません。
マイクロソフトリサーチアジアの研究者は、初期の段階で、公開されている多くの文学や現代中国のデータを収集しましたが、オリジナルのデータをそのまま使用することはできません。さまざまなソース、さまざまなフォーマットのデータを正規化するために、データクリーニングを行う必要があります。また、全角/半角のデータを正規化するために、データクリーニングを行う必要があります。半角文字のパンク, は、無効なデータがモデル学習に与える影響を最小限に抑えるための手段です。このようにして、実際に利用可能な高品質のデータをさらに減らすことができます。
マイクロソフト・リサーチ・アジアの研究者であるShuming Ma氏によると、データのスパースネスの問題を軽減するために、研究者たちは以下のような膨大な量のデータ合成と補強作業を行ってきたという。
まず、共通のキャラクター– ベースのアラインメントと拡張により、トレーニングデータのサイズを大きくすることができます。 とは異なります。 中国語と英語、フランス語、ロシア語などの他の言語との翻訳では、文語と現代中国語が同じ文字セットを使用しています。この特徴を利用して、マイクロソフトリサーチアジアの研究者たちは、革新的なアルゴリズムを用いて、機械翻訳が一般的な文字を呼び出し、自然な整列を行い、さらに単語、フレーズ、短文へと展開することで、大量の使用可能なデータを合成しています。
2つ目は、機械翻訳のロバスト性を高めるために文構造を変形させること。 については 詩や文章の中には、機械が古代の詩をより包括的に学習できるように、いくつかのバリエーションが加えられています。人間は、詩のように全文ではなくリズムに合わせて行を区切っているような異常な構造の文章を見ても、パーツを組み合わせて理解することができます。しかし、そのような区分けを見たことのない翻訳モデルにとっては、混乱してしまう可能性が高いのです。したがって、データ形式の変換は、学習データの量を拡大するだけでなく、翻訳モデルの学習のロバスト性を向上させることができるのです。
第三に、モデルの適応性を高めるために、繁体字と簡体字の翻訳トレーニングを行う。 中国語では、文語と現代語の両方に繁体字が存在しています。研究者はモデルを学習する際、モデルの適応性を高めるために、簡体字のデータだけでなく、繁体字のデータや繁体字と簡体字が混ざったデータも追加しました。これにより、モデルは繁体字と簡体字の両方の内容を理解できるようになり、より正確な翻訳結果が得られるようになった。
4つ目は、翻訳の精度を高めるために、外国語の単語のトレーニングを増やすこと。 現代中国語を文学的な中国語に翻訳する場合、外国語の単語から派生した現代語の単語や、「Microsoft」、「computer」、「high-speed rail」など、古代中国語には登場しない新しい単語がしばしば登場します。この問題に対処するため、研究者はエンティティを認識する小さなモデルを訓練しました。このモデルは、まず実体の外側にある単語の意味を翻訳し、次に実体を埋め戻して機械の精度を確保しました。’が外国語を処理していることがわかります。
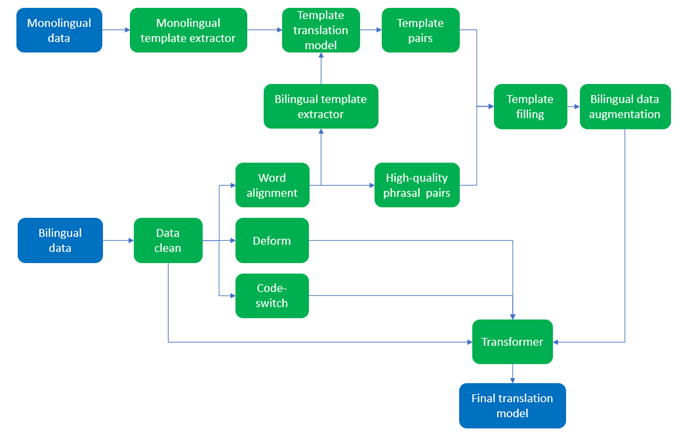
イメージT彼 文学的中国語 翻訳プロセス
また、ブログ、フォーラム、Weiboなどの非公式な文体に対しては、機械翻訳モデルを特別に学習させ、現代中国語と文学的な中国語の間の翻訳の堅牢性をさらに高めています。
Dongdong Zhangは、「現在の翻訳システムをベースに、データセットの充実とモデルの学習方法の改善を続け、よりロバストで汎用性の高いものにしていきます」と表現しています。将来的には、この手法は中国語の文芸翻訳だけではなく、他のアプリケーションシナリオにも拡張できるでしょう。"


