
การแปลเครื่องระบบประสาทการเปิดใช้งานนวัตกรรมพาริตี้ของมนุษย์ในคลาวด์
ในเดือนมีนาคม๒๐๑๘ที่เรา ประกาศ (ฮัสสัน๒๐๑๘) ผลการพัฒนาที่เราได้แสดงเป็นครั้งแรกที่ระบบการแปลเครื่องที่สามารถดำเนินการเช่นเดียวกับนักแปลของมนุษย์ (ในสถานการณ์ที่เฉพาะเจาะจง-แปลข่าวภาษาจีน-อังกฤษ) นี้เป็นความก้าวหน้าที่น่าตื่นเต้นในการวิจัยเครื่องแปลภาษา, แต่ระบบที่เราสร้างขึ้นสำหรับโครงการนี้เป็นระบบการวิจัยที่ซับซ้อน, เฮฟวี่เวท, ผสมผสานเทคนิคการตัดขอบหลาย. ในขณะที่เราออกจากการส่งออกของระบบนี้ในหลายชุดทดสอบ, ระบบตัวเองไม่เหมาะสำหรับการปรับใช้ในเวลาจริงการแปลเครื่องคอมพิวเตอร์เมฆ API.
วันนี้เรารู้สึกตื่นเต้นที่จะประกาศความพร้อมในการผลิตของระบบประสาทรุ่นล่าสุดของเราแบบจำลองการแปลเครื่อง รุ่นเหล่านี้รวมความดีที่สุดของความดีของระบบการวิจัยของเราและตอนนี้สามารถใช้ได้โดยค่าเริ่มต้นเมื่อคุณใช้ Microsoft แปล API รูปแบบใหม่เหล่านี้มีอยู่ในวันนี้ในจีน, เยอรมัน, ฝรั่งเศส, ภาษาฮินดี, อิตาลี, สเปน, ญี่ปุ่น, เกาหลี, และรัสเซีย, จากและเป็นภาษาอังกฤษ. ภาษาอื่นๆจะมาเร็วๆนี้
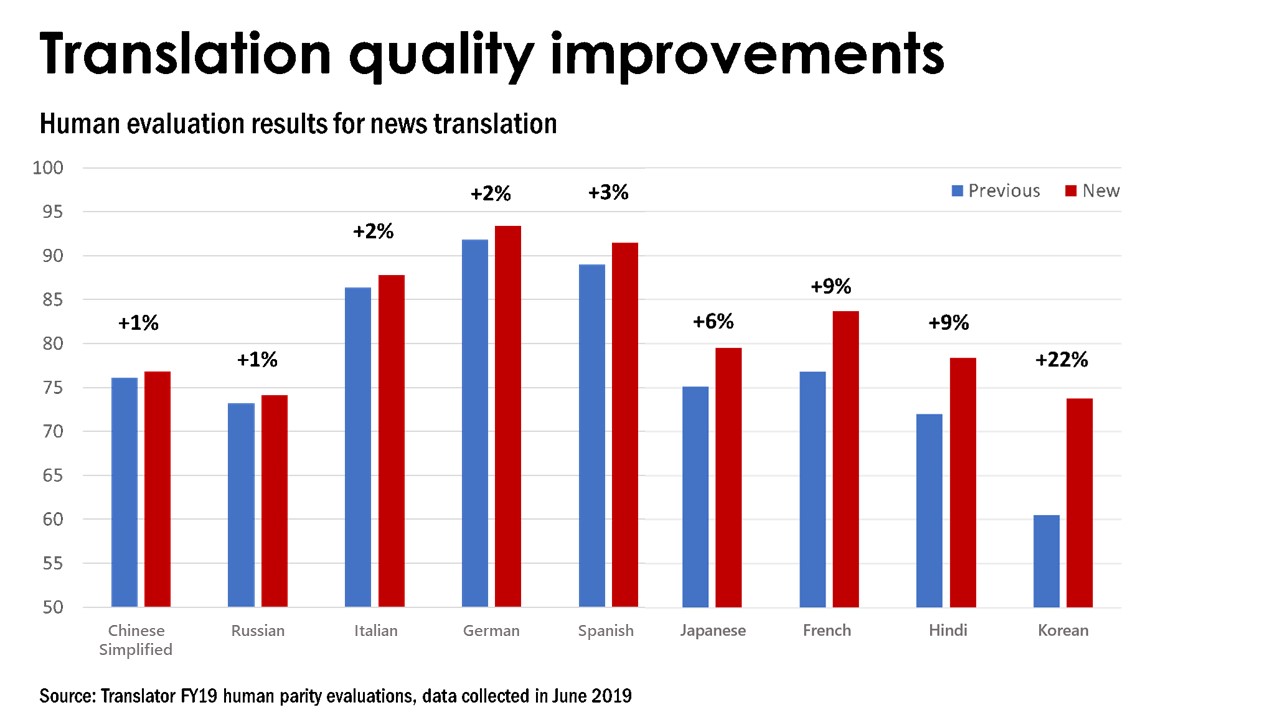
การเดินทางจากกระดาษวิจัยไปยัง Cloud API
ในปีที่ผ่านมาเราได้รับการมองหาวิธีที่จะนำมาซึ่งคุณภาพของระบบพาริตี้มนุษย์ของเราใน Microsoft แปล APIในขณะที่ยังคงเสนอการแปลแบบเรียลไทม์ที่มีค่าใช้จ่ายต่ำ นี่คือบางส่วนของขั้นตอนในการเดินทางนั้น
ครู-นักเรียนฝึกอบรม
ขั้นตอนแรกของเราคือการเปลี่ยนไปใช้กรอบงาน "ครูนักเรียน" ที่เราฝึกนักเรียนแบบ real-time ที่มีน้ำหนักเบาในการเลียนแบบเครือข่ายครูที่มีเฮฟวี่เวท (Ba และ Caruana ๒๐๑๔). นี่คือความสำเร็จโดยการฝึกอบรมนักเรียนไม่ได้อยู่ในข้อมูลคู่ขนานที่ระบบ MT มักจะได้รับการฝึกฝนในแต่ในการแปลที่ผลิตโดยครู (คิมและรัช๒๐๑๖). นี่คืองานที่ง่ายกว่าการเรียนรู้จากข้อมูลดิบและช่วยให้ shallower นักเรียนที่ง่ายต่อการปฏิบัติตามครูที่ซับซ้อนอย่างใกล้ชิด ในฐานะที่เป็นหนึ่งอาจคาดหวัง, ความพยายามเริ่มต้นของเรายังคงทนทุกข์คุณภาพลดลงจากครูนักเรียน (ไม่มีอาหารกลางวันฟรี!), แต่เรายังคงเอาสถานที่แรกในการ๒๐๑๘การใช้งานร่วมกันในการถอดรหัสอย่างมีประสิทธิภาพ (ได้รับการออกแบบ). บางผลที่น่าตื่นเต้นโดยเฉพาะอย่างยิ่งจากความพยายามนี้คือหม้อแปลง (ภาษาของท่าน๒๐๑๗) รุ่นและการปรับเปลี่ยนของพวกเขาเล่นได้ดีกับครู-นักเรียนฝึกอบรมและมีประสิทธิภาพ astoundingly ในระหว่างการอ้างอิงในซีพียู
การเรียนรู้จากผลเริ่มต้นเหล่านี้และหลังจากจำนวนมากของการเกิดซ้ำเราค้นพบสูตรที่ช่วยให้นักเรียนที่เรียบง่ายของเราจะมีเกือบที่มีคุณภาพเดียวกับครูที่ซับซ้อน (บางครั้งมีอาหารกลางวันฟรีหลังจากทั้งหมด?). ตอนนี้เรามีอิสระในการสร้างรูปแบบครูขนาดใหญ่ที่ซับซ้อนเพื่อเพิ่มคุณภาพโดยไม่ต้องกังวลเกี่ยวกับข้อจำกัดแบบเรียลไทม์ (มากเกินไป)
การแปลแบบเรียลไทม์
การตัดสินใจของเราที่จะเปลี่ยนไปใช้กรอบงานของครูนักเรียนได้รับแรงกระตุ้นจากผลงานที่ยิ่งใหญ่โดย คิมและรัช (๒๐๑๖) สำหรับรุ่นที่ใช้ RNN แบบง่าย ที่จุดนั้นมันก็ไม่ชัดเจนถ้าผลประโยชน์ที่รายงานจะแสดงรายการสำหรับรุ่นหม้อแปลงเช่นกัน (ดู ภาษาของท่าน๒๐๑๗ สำหรับรายละเอียดเกี่ยวกับรุ่นนี้) อย่างไรก็ตามเราค้นพบได้อย่างรวดเร็วว่านี่เป็นกรณีที่แท้จริง
นักศึกษาหม้อแปลงสามารถใช้ขั้นตอนวิธีการถอดรหัสง่ายมาก (ค้นหาโลภ) ที่เราเพียงแค่เลือกคำแปลที่ดีที่สุดเดียวในแต่ละขั้นตอนมากกว่าวิธีการปกติ (การค้นหาคาน) ซึ่งเกี่ยวข้องกับการค้นหาผ่านพื้นที่ขนาดใหญ่ที่เป็นไปได้ แปล การเปลี่ยนแปลงนี้มีผลกระทบที่มีคุณภาพน้อยที่แต่นำไปสู่การปรับปรุงใหญ่ในความเร็วในการแปล โดยความคมชัดแบบจำลองครูจะต้องมีคุณภาพลดลงอย่างมีนัยสำคัญเมื่อสลับจากการค้นหาแบบคานเพื่อค้นหาโลภ
ในเวลาเดียวกัน, เราตระหนักว่ามากกว่าการใช้สถาปัตยกรรมประสาทล่าสุด (หม้อแปลงที่มีความสนใจด้วยตนเอง) ในตัวถอดรหัส, นักเรียนสามารถแก้ไขเพื่อใช้สถาปัตยกรรมที่กำเริบและเร็วขึ้น (RNN). เรื่องนี้เนื่องจากในขณะที่ตัวเข้ารหัส Transformer สามารถคำนวณผ่านประโยคต้นฉบับทั้งหมดในแบบคู่ขนานประโยคเป้าหมายจะถูกสร้างขึ้นเป็นคำเดียวในเวลาดังนั้นความเร็วของตัวถอดรหัสมีผลกระทบใหญ่ต่อความเร็วโดยรวมของการแปล เมื่อเทียบกับการให้ความสนใจด้วยตนเองตัวถอดรหัสที่เกิดขึ้นจะช่วยลดความซับซ้อนของอัลกอริทึมจากการเป็นสองเท่าของเส้นตรง โดยเฉพาะอย่างยิ่งในการตั้งค่าครูนักเรียน, เราเห็นไม่สูญเสียในคุณภาพเนื่องจากการปรับเปลี่ยนเหล่านี้, ไม่สำหรับอัตโนมัติหรือสำหรับผลการประเมินของมนุษย์. การปรับปรุงเพิ่มเติมหลายอย่างเช่นการใช้พารามิเตอร์ร่วมกันนำไปสู่การลดความซับซ้อนและเพิ่มขึ้นอย่างรวดเร็ว
ข้อได้เปรียบอีกประการหนึ่งของกรอบการศึกษาของครูนักเรียนที่เราตื่นเต้นมากที่เห็นคือการปรับปรุงคุณภาพในช่วงเวลาของการเจริญเติบโตและการเปลี่ยนแปลงของครูที่เคยมีการดำเนินการไปยังสถาปัตยกรรมของนักเรียนที่ไม่เปลี่ยนแปลง ในกรณีที่เราเห็นปัญหาในเรื่องนี้, เพิ่มขึ้นเล็กน้อยในความจุแบบจำลองนักเรียนจะปิดช่องว่างอีกครั้ง.
การเรียนรู้แบบคู่
ความเข้าใจสำคัญที่อยู่เบื้องหลังการเรียนรู้แบบคู่ (เขา et al. ๒๐๑๖) เป็น "การแปลแบบไปกลับ" ตรวจสอบว่าคนบางครั้งใช้ในการตรวจสอบคุณภาพการแปล สมมติว่าเรากำลังใช้การแปลออนไลน์เพื่อไปจากภาษาอังกฤษเป็นภาษาอิตาลี ถ้าเราไม่ได้อ่านอิตาลีเราจะรู้ได้อย่างไรว่ามันทำงานที่ดีหรือไม่? ก่อนคลิก ส่ง ใน email เราอาจเลือกที่จะตรวจสอบคุณภาพโดยการแปลภาษาอิตาลีกลับเป็นภาษาอังกฤษ (อาจจะอยู่ในเว็บไซต์อื่น) ถ้าภาษาอังกฤษที่เรากลับได้หลงเหลืออยู่ไกลจากเดิมโอกาสเป็นหนึ่งในการแปลออกไปจากราง
การเรียนรู้แบบ Dual ใช้วิธีการเดียวกันในการฝึกอบรมสองระบบ (เช่นภาษาอังกฤษ-> อิตาลีและอิตาลี >) ในแบบคู่ขนานโดยใช้การแปลการเดินทางไปกลับจากระบบหนึ่งเพื่อทำคะแนนตรวจสอบและฝึกอบรมระบบอื่นๆ
การเรียนรู้แบบ Dual เป็นผู้สนับสนุนหลักในการวิจัยของมนุษย์ ในการไปจากระบบการวิจัยเพื่อสูตรการผลิตของเราเราโดยทั่วไปวิธีการนี้อย่างกว้างขวาง ไม่เพียงแต่เราร่วมรถไฟคู่ของระบบในการส่งออกของแต่ละอื่นๆเรายังใช้เกณฑ์เดียวกันสำหรับการกรองข้อมูลคู่ขนานของเรา
การล้างข้อมูลที่ไม่ถูกต้อง
ระบบการแปลภาษาได้รับการฝึกอบรมใน "ข้อมูลคู่ขนาน" เช่นคู่ของเอกสารที่มีการแปลของแต่ละอื่นๆที่สร้างขึ้นโดยนักแปลของมนุษย์ ข้อมูลแบบขนานนี้มักจะเต็มไปด้วยการแปลที่ไม่ถูกต้อง บางครั้งเอกสารที่ไม่ขนานแท้จริงแต่เพียงหลวมการออกแบบของแต่ละอื่นๆ นักแปลของมนุษย์สามารถเลือกที่จะออกจากแหล่งที่มาบางส่วนหรือแทรกข้อมูลเพิ่มเติม ข้อมูลอาจมีการพิมพ์ผิดพลาดในการสะกดผิด บางครั้งอัลกอริทึมการทำเหมืองข้อมูลของเราจะถูกหลอกด้วยข้อมูลที่คล้ายกันแต่ไม่ขนานหรือแม้แต่ประโยคในภาษาที่ไม่ถูกต้อง ที่แย่ที่สุดของทั้งหมด, จำนวนมากของหน้าเว็บที่เราเห็นเป็นสแปม, หรืออาจในความเป็นจริงเป็นเครื่องแปลภาษาแทนการแปลของมนุษย์. ระบบประสาทมีความไวต่อชนิดของไม่ถูกต้องในข้อมูล. เราพบว่าการสร้างรูปแบบประสาทเพื่อระบุและกำจัดความไม่ถูกต้องเหล่านี้ให้การปรับปรุงที่แข็งแกร่งในคุณภาพของระบบของเรา. แนวทางของเราในการกรองข้อมูลส่งผลให้เกิดเป็นอันดับแรกใน WMT18 การกรองแบบขนานของ corpus (ในการ) และช่วยสร้างระบบแปลภาษาอังกฤษที่แข็งแกร่งที่สุดแห่งหนึ่งใน WMT18 งานแปลข่าว (การยกขบวน-Dowmunt 2018b). เราใช้วิธีการนี้ในการปรับปรุงระบบการผลิตที่เราได้เปิดตัวในวันนี้
การให้คำรับรอง
เมื่อย้ายเทคโนโลยีการวิจัยเพื่อการผลิต, ความท้าทายหลายโลกจริงเกิดขึ้น. การรับตัวเลข, วันที่, เวลา, ตัวพิมพ์ใหญ่, ระยะห่าง, ฯลฯสิ่งที่ถูกต้องมากขึ้นในการผลิตมากกว่าในระบบการวิจัย.
พิจารณาความท้าทายของการเป็นตัวพิมพ์ใหญ่ ถ้าเรากำลังแปลประโยค "วิดีโอ CAT WATCH ที่นี่" เรารู้วิธีการแปล "แมว" เราต้องการที่จะแปล "CAT" ในลักษณะเดียวกัน แต่ตอนนี้คิดว่า "ดูฟุตบอลสหรัฐที่นี่" เราไม่ต้องการที่จะสับสนคำว่า "เรา" และคำย่อ "เรา" ในบริบทนี้
ในการจัดการนี้เราใช้วิธีการที่เรียกว่าการแปลภาษาเครื่อง (Koehn และ Hoang ๒๐๐๗, ที่ร่ำรวยและ Haddow ๒๐๑๖) ซึ่งทำงานดังนี้ แทนการแสดงตัวเลขเดียว ("ฝัง") สำหรับ "cat" หรือ "CAT" เราใช้ชุดเครื่องนอนหลายที่เรียกว่า "ปัจจัย" ในกรณีนี้การฝังหลักจะเหมือนกันสำหรับ "CAT" และ "cat" แต่ปัจจัยที่แยกต่างหากจะแสดงถึงตัวพิมพ์ใหญ่แสดงให้เห็นว่ามันเป็นทั้งหมดหมวกในหนึ่งอินสแตนซ์แต่ตัวพิมพ์เล็กในอีก ปัจจัยที่คล้ายกันจะใช้กับแหล่งที่มาและด้านเป้าหมาย
เราใช้ปัจจัยที่คล้ายกันในการจัดการคำและระยะห่างระหว่างคำ (ปัญหาที่ซับซ้อนในภาษาที่ไม่ใช่ระยะห่างหรือการเว้นระยะห่างระหว่างช่องทางเช่นจีนเกาหลีญี่ปุ่นหรือไทย)
ปัจจัยยังปรับปรุงอย่างมากการแปลของตัวเลขซึ่งเป็นสิ่งสำคัญในหลายสถานการณ์ การแปลหมายเลขส่วนใหญ่เป็นการเปลี่ยนแปลงของอัลกอริทึม ตัวอย่างเช่น, ๑,๒๓๔,๐๐๐สามารถเขียนเป็น 12, 34000 ในภาษาฮินดี, 1.234.000 ในเยอรมัน, และ๑๒๓.๔万ในภาษาจีน. ประเพณี, ตัวเลขจะถูกแสดงเช่นคำ, เป็นกลุ่มของตัวละครที่มีความยาวแตกต่างกัน. นี้จะทำให้มันยากสำหรับการเรียนรู้เครื่องที่จะค้นพบอัลกอริทึม. แทน, เราให้อาหารทุกหลักเดียวของจำนวนแยกต่างหาก, มีปัจจัยการทำเครื่องหมายจุดเริ่มต้นและสิ้นสุด. เคล็ดลับง่ายๆนี้ robustly และเอาออกได้อย่างน่าเชื่อถือเกือบทุกข้อผิดพลาดการแปล
การฝึกอบรมแบบจำลองได้เร็วขึ้น
เมื่อเรากำลังฝึกอบรมระบบเดียวกับเป้าหมายเดียว, ในขณะที่เราทำสำหรับโครงการวิจัยมนุษย์พาริตี, เราคาดว่าจะโยนจำนวนมากของฮาร์ดแวร์ในรุ่นที่ใช้เวลาหลายสัปดาห์ในการฝึกอบรม. เมื่อการฝึกอบรมแบบจำลองการผลิตสำหรับคู่ภาษา 20 + วิธีการนี้จะกลายเป็นไม่สามารถทำได้ ไม่เพียงแต่เราจำเป็นต้องเปิดรอบเวลาที่เหมาะสมแต่เรายังต้องการที่จะดูแลฮาร์ดแวร์ของเรา สำหรับโครงการนี้เราได้ทำการปรับปรุงประสิทธิภาพในการ แมเรียน (การเฉลิมพระชนมพรรษา-Dowmunt et al. 2018b).
แมเรียนคือโอเพนซอร์สเครื่อง toolkit MT ที่ไมโครซอฟท์แปลเป็นพื้นฐาน. แมเรียนเป็นเครื่องมือการแปลภาษาของ c ++ บริสุทธิ์และเป็นผลให้มีประสิทธิภาพมากไม่จำเป็นต้องใช้ Gpu ในขณะทำงานและมีประสิทธิภาพมากในเวลาการฝึกอบรม
เนื่องจากธรรมชาติที่มีอยู่ในตัวมันค่อนข้างง่ายที่จะเพิ่มประสิทธิภาพแมเรียนสำหรับงานที่เฉพาะเจาะจง NMT ซึ่งส่งผลให้หนึ่งในชุดเครื่องมือ NMT ที่มีประสิทธิภาพมากที่สุด ลองดูที่ มาตรฐาน. หากคุณมีความสนใจในการวิจัยและพัฒนาของระบบประสาท MT, โปรดเข้าร่วมและนำไปสู่ ชุมชนบน Github.
การปรับปรุงของเราเกี่ยวกับการฝึกอบรมความแม่นยำผสมและการถอดรหัสเช่นเดียวกับการฝึกอบรมแบบจำลองขนาดใหญ่เร็วๆนี้จะสามารถทำได้ในพื้นที่เก็บข้อมูล Github สาธารณะ
เรารู้สึกตื่นเต้นเกี่ยวกับอนาคตของการแปลเครื่องระบบประสาท เราจะยังคงกลิ้งออกสถาปัตยกรรมรูปแบบใหม่ไปยังภาษาที่เหลือและ นักแปลที่กำหนดเอง ตลอดปีนี้ ผู้ใช้ของเราจะได้รับการแปลที่มีคุณภาพดีกว่าโดยอัตโนมัติผ่าน แปล API, ความ แอพพลิเคแปล, Microsoft Office และเบราว์เซอร์ขอบ เราหวังว่าการปรับปรุงใหม่ช่วยให้ชีวิตส่วนบุคคลและมืออาชีพของคุณและมองไปข้างหน้าเพื่อความคิดเห็นของคุณ
อ้าง อิง
- จิมมีบาและริช ๒๐๑๔ลึกต้องการที่จะลึก? เงินทดรองจ่ายระบบประมวลผลข้อมูล หน้า2654-2662 https://papers.nips.cc/paper/5484-do-deep-nets-really-need-to-be-deep
- ที่นี่, แอนโทนีได้ยิน, ช้างเฉิน, วิทยาทารี, โจนาธานคลาร์ก, คริสเตียนเฟเชียล, Xuedong Huang, Marcin Junczys-Dowmunt, วิลเลียมลูอิส, Mu Li, Shujie Liu, Tie-Yan Liu, Renqian Luo, Arul Menezes, เต่า Qin, Frank Seide, Xu Tan, Fei Tian, Lijun Wu ซวงจือ Wu, Yingce, ดองดงจาง, Zhirui จาง, หมิง. ๒๐๑๘. บรรลุพาริตี้ของมนุษย์ในภาษาจีนอัตโนมัติเป็นภาษาอังกฤษแปลข่าว. http://arxiv.org/abs/1803.05567
- เขา, Di และ Xia, หยิงและ Qin, เต่าและวัง, Liwei และ Yu, Nenghai และหลิว, Tie-Yan และ Ma, Wei-Ying. ๒๐๑๖การเรียนรู้แบบ Dual สำหรับการแปลภาษาด้วยเครื่อง เงินทดรองจ่ายระบบประมวลผลข้อมูล หน้า820-828 https://papers.nips.cc/paper/6469-dual-learning-for-machine-translation
- มาซิน 2018a. คู่แบบมีเงื่อนไขการกรองข้ามเอนโทรปี การดำเนินการประชุมครั้งที่สามในการแปลภาษาเครื่อง: เอกสารงานที่ใช้ร่วมกัน เบลเยี่ยมหน้า888-895 https://aclweb.org/anthology/papers/W/W18/W18-6478/
- มาซิน การส่งของ Microsoft ไปยังงาน WMT2018 ข่าวการแปล: วิธีที่ฉันเรียนรู้ที่จะหยุดกังวลและรักข้อมูล การดำเนินการประชุมครั้งที่สามในการแปลภาษาเครื่อง: เอกสารงานที่ใช้ร่วมกัน เบลเยี่ยมหน้า425-430 https://www.aclweb.org/anthology/W18-6415/
- Heafield, แอนโทนีฮวง, โรแมน, โรมัน, มันซิน, ฝรั่งเศส 2018a แมเรียน: ค่าใช้จ่ายที่มีประสิทธิภาพสูงเครื่องมือประสาทการแปลใน c ++ การดำเนินการของการประชุมเชิงปฏิบัติการครั้งที่2ในการแปลและการสร้างเครื่องจักรประสาท เมลเบิร์นออสเตรเลียหน้า129-135 https://aclweb.org/anthology/papers/W/W18/W18-2716/
- มาร์ซิน-Dowmunt, โรมัน Grundkiewicz, ชอบ Dwojak, Hieu Hoang, ได้ Heafield, ทอม Neckermann, Frank Seide, อุริกซี, Alham Fikri Aji, นิกิ Bogoychev, André F. t. มาร์ติน, อเล็กซานดราเบิร์ช. 2018b แมเรียน: การแปลเครื่องจักรประสาทอย่างรวดเร็วใน c ++ การดำเนินการของ ACL ๒๐๑๘, การสาธิตระบบ เมลเบิร์นออสเตรเลียหน้า116-121 https://www.aclweb.org/anthology/P18-4020/
- ยุนคิมและอเล็กซานเดอร์เอ็ม. ๒๐๑๖. การกลั่นความรู้ระดับลำดับ ในการพิจารณาคดีของ๒๐๑๖การประชุมเชิงประจักษ์ในการประมวลผลภาษาธรรมชาติ, EMNLP ๒๐๑๖, ออสติน, เท็กซัส, สหรัฐอเมริกา, พฤศจิกายน 1-4, ๒๐๑๖, หน้า1317– 1327. https://aclweb.org/anthology/papers/D/D16/D16-1139/
- ภาษาของท่าน ๒๐๐๗แบบจำลองการแปล. การดำเนินการของการประชุมร่วมกัน๒๐๐๗ในวิธีการเชิงประจักษ์ในการประมวลผลภาษาธรรมชาติและการเรียนรู้ภาษาธรรมชาติการคำนวณ (EMNLP-CoNLL) ปราก, สาธารณรัฐเช็ก, หน้า868-876 https://www.aclweb.org/anthology/D07-1091/
- ริโก้ ๒๐๑๖คุณสมบัติการป้อนข้อมูลภาษาการปรับปรุงการแปลเครื่องระบบประสาท การดำเนินการประชุมครั้งแรกในการแปลเครื่อง: เล่ม 1, เอกสารการวิจัย. เบอร์ลิน, เยอรมนี, หน้า83-91 https://www.aclweb.org/anthology/W16-2209/
- , Ashish และ Shazeer, Noam และ Parmar, นิกิและ Uszkoreit, อบและโจนส์, Llion และโกเมซ, Aidan N และ Kaiser, Lukasz และ Poloสุขาภิบาลใน, Illia. ๒๐๑๗ความสนใจเป็นสิ่งที่คุณต้องการ การก้าวหน้าของระบบประมวลผลข้อมูล หน้า5998-6008 https://papers.nips.cc/paper/7181-attention-is-all-you-need


