
微软亚洲研究院
ニュース&特集
| Heecheol Kim と Namiko Saito
As Microsoft Research Asia – Tokyo’s first research intern, Lilika Makabe brought her computer vision expertise into embodied AI and robotics, exploring new research questions through hands-on experimentation and interdisciplinary collaboration.
阅读技术报告时,我们经常会发现,一份报告的结论可能写在摘要里,成立条件藏在方法章节,关键数字位于表格,限制则出现在附录。所以找到一句相关的话,并不等于研究清楚一个问题。如果每次追问都要重新翻找,那阅读成果便难以积累;如果评测只看最终答案是否正确,那么将很难判断系统究竟读到了什么、遗漏了什么。 近期,微软亚洲研究院推出的 DocAtlas 与 XL-DocBench,分…
2026年8月,SkillOpt在开源社区迅速走红。上线仅一周,项目就在GitHub斩获4600颗星,两个月便攀升至17,200颗星。 作为SkillOpt技术研究与开发的核心成员之一,微软亚洲研究院高级研究员杨一帆坦言SkillOpt所受到的关注既在情理之中,也在意料之外。“我们从一开始就很笃定,这项工作的底层价值足够扎实,它瞄准的是智能体长期发展的基础性问题。我们尝试从一个新的角度切入,在模型…
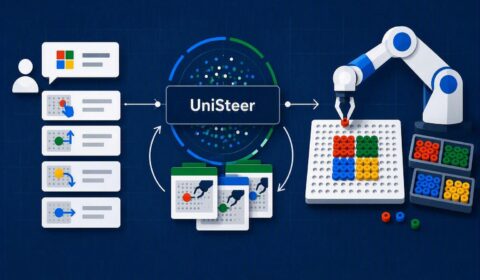
视觉 – 语言 – 动作模型(Vision-Language-Action Model,VLA)正在成为机器人操作的重要基础模型。经过少量示范微调后,VLA 已经能够完成抓取、放置、堆叠等多种任务。然而,一旦任务涉及精密接触、狭小容差或分布外位置,模型的成功率仍会明显下降。 这也是为什么真机强化学习如此重要:预训练和模仿学习赋予了机器人一个不错的起点,而强化学习则让机器人能够在真实环境中继续试错,…
Today, the chat window is still the main way people interact with large models and agents: users ask a question, the AI answers, and each follow-up extends the thread. This is simple and natural, but fundamentally linear. When a question…
如今,我们和大模型、Agent交互最常见的方式仍然是聊天窗口,人们提出问题,AI给出回答,沿着回答继续追问,对话便不断向下延伸。这种交互方式简单、自然,但本质上是线性的。当一个问题同时产生多个值得探索的方向时,人们往往只能选择其中一条继续深入,其他信息则逐渐被淹没在越来越长的对话记录中。 然而人类的思考并不是线性的。我们会在不同想法之间来回跳转,将多份关联资料摆放在一处对比;会暂时搁置某个问题,隔…
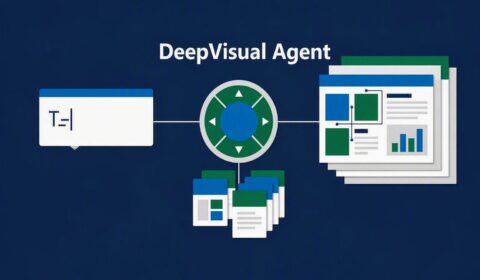
对于人类来说,视觉始终是信息获取效率最高的通道。神经科学研究表明,人类大脑每秒接收约1100万比特的感官信息,其中约80%来自视觉,但人脑有意识层面的信息处理速度仅有10–50比特/秒。视觉不仅承载着绝大部分信息输入,也是人类理解复杂内容、组织知识与完成决策的重要方式。但在生成式AI席卷全球的今天,绝大多数大模型与智能体依然停留在文本输出阶段。 由于文本输出的限制,原本旨在提升效率的AI反而给用户…
随着 AI Agent 从单纯的模型逐渐演化为由模型、工具和执行环境共同组成的复杂系统,Agent 的能力越来越依赖于模型之外的 Agent Harness(Agent运行框架)。 然而,当我们希望通过强化学习(RL)进一步提升 Agent 能力时,一个现实问题出现了:许多现有 Agent RL 系统要求开发者将 Agent 重新实现到训练框架内部。这不仅增加了工程成本,也让训…
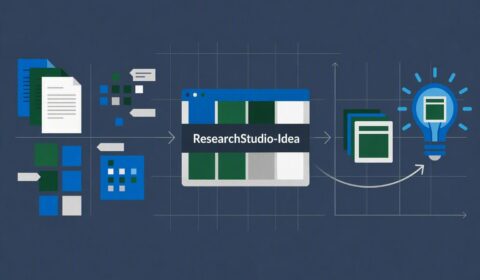
如今,让大模型“想一个研究点子”已不是难事,检索文献、提出假设、写出一份看起来有模有样的提案,现有系统都能做到。真正难的其实是有点子之前的那段路。如何把一个模糊的方向落到当前文献里、找出真正没被解决的瓶颈、和已有工作划清界限、在动手实验之前评估风险?这段科研中的第一公里,目前基本都是依赖研究者的个人经验。 微软亚洲研究院联合南洋理工大学(NTU)、新加坡国立大学(NUS)和A*STAR CFAR …