
微软亚洲研究院
뉴스 & 기능
当我们让 AI 扮演一位用户时,它通常能够快速给出像模像样的回答。它可以模仿一个影迷挑选电影,模仿一位网友讨论问题,也可以根据历史足迹预测一个人下一站会去哪里。 随着大模型能力的快速提升,智能 NPC、用户模拟器、社会仿真等应用正在变得越来越真实。但一个更关键的问题是:AI生成的行为,真的像人吗? 它是否真的理解了一个人的偏好、思维方式和长期习惯?它能否在多轮交互后依…
大模型预训练一直是一件”既要又要”的事情:既希望训练稳定、可持续扩展,又希望训练效率达到极致。这一过程就像“戴着镣铐跳舞”,既要满足各种约束,又要尽可能发挥模型潜力,无疑是一门兼具理论与工程之美的 AI 艺术。 近日,微软亚洲研究院的研究员们提出了一个全新的优化器Spectral Sphere Optimizer(SSO)。该工作从 μP(Maximal Update Parametrizatio…
当你向AI模型询问“法国大革命期间,路易十六被处决的具体日期是哪一天”,它能迅速给出“1793年1月21日”的标准答案。可当你追问某个冷门的地方戏曲流派起源时,它却可能面不改色地编造出一个听起来头头是道的虚假地名。这种一本正经地胡说八道的现象,就是大模型的幻觉。 这种幻觉不像代码报错那样直接崩溃,而是以极高的可信度输出错误信息。在闲聊场景中,这或许只是茶余饭后的笑料,但在医疗、法律或金融等关键领域…
本期内容速览: 1.基于人格提示的大语言模型能否模拟文化子群体价值观偏好? 2.CAReDiO:基于代表性与差异性的大语言模型文化对齐数据优化方法 3.DisAlign:解耦共识与价值表征,实现大模型可控多元价值观对齐 4.基于价值观编码表的大模型文化价值观对齐分布式开放评测 5.MMA-ASIA:面向原生文化感知的多语言多模态文化对齐评测框架 6.PICACO:基于总相关性优化的多元上下文价值观…
AI 能考过计算机等级考试吗?
如果让今天最强的大模型去参加一场国家计算机等级考试(NCRE),它能拿多少分? 近期,微软亚洲研究院的研究员们把 NCRE 一、二级的 200 道 Word、Excel、PPT 实操题搬到 AI 面前,让 7 个前沿大模型作答,并用官方评分引擎逐条打分。然而,测试结果却与我们的直觉大相径庭:在普通考生普遍能拿满分的考试中,最强单轮模型只考了 36.6 分;即便是配上了能反复执行调试的“编程智能体”…
过去几年的AI发展史,可以说是一部“暴力美学”的进化史。从百亿参数到万亿参数,从千卡集群到万卡集群,行业笃信一条法则:只要算力够大、数据够多,模型的边界就会被不断打破。正是这条 Scaling Law(规模法则),让众多模型一次次迎来能力质变。然而,当单次训练耗电持续攀升,当模型在深度推理中显露不足时,我们不禁要问:单纯依靠算力堆砌的发展模式,是否已经走到瓶颈? 作为经过数亿年演化形成的生物智能系…
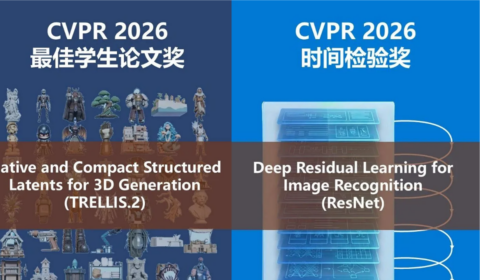
在刚刚落幕的计算机视觉与人工智能领域最具影响力的国际顶会之一 CVPR 2026 上,来自微软亚洲研究院的论文《Native and Compact Structured Latents for 3D Generation》(即TRELLIS.2)从全球 16,092篇投稿中脱颖而出,荣膺最佳学生论文奖(Best Student Paper Award)。 作为全新的 3D 资产生成范式,TREL…
《AI Next》是微软亚洲研究院推出的一档利用 AI 技术制作的播客,内容聚焦 AI 前沿技术、科研趋势与社会影响。第一季主要围绕当今智能发展的核心议题,探索前沿趋势。 作为本季收官之作,第八期节目请到了微软亚洲研究院院长周礼栋博士,与大家深度探讨 AI 与底层系统的协同进化,一起拆解智能时代基础设施的重构逻辑。周院长将通过解析系统…
在大语言模型 (LLMs) 的训练中,数据的高效利用是决定模型最终能力的关键。过去的很多研究将精力集中在“数据筛选”(Data Selection)上,也就是如何从海量互联网语料中挑出最高质量的子集。 如今,这个问题依然十分重要。当前大模型通常只在海量数据上训练一轮或少数几轮,模型很可能只“读”一遍教材,因此数据样本呈现的时间顺序直接决定了模型的学习轨迹。如果把训练过程类比为上课,那么数据选择决定…