
同样的模型、同样的输入、同样的随机种子,换一块 GPU 运行,结果却可能不一样。
在大模型时代,这类数值差异不只是工程上的小麻烦,还可能影响模型质量、实验可复现性和训练稳定性。那么问题出在哪里?答案往往藏在 GPU 内部那些没有写进文档的算术细节里。
为了看清这些细节,微软亚洲研究院的研究员们提出了闭环特征探测方法 CLFP,并据此构建了 MMA-Sim。MMA-Sim 是一套位精确的 GPU 矩阵乘累加(MMA)模型,覆盖 NVIDIA 和AMD 的十种 GPU 架构,能够逐比特复现所测试指令的输出,解释跨平台的数值差异,并为精度改进提供指导。相关论文已被计算机体系结构领域顶级会议 MICRO 2026 收录,代码也已开源。
小误差,大麻烦:被忽视的硬件“算术账”
大语言模型(LLMs)会执行海量的浮点运算。一个微小的算术差异,可能在不同层和多次迭代中不断累积、放大,最终改变模型计算出的概率分布及其输出的 token。因此,数值行为对于模型质量、可复现性和训练稳定性至关重要。
现有关于数值行为的研究大多聚焦于软件因素,硬件层面的算术行为却很少有人深究。实际上,硬件同样会带来两个棘手的问题:
一是数值差异。用相同的输入在不同 GPU 平台上运行同一个模型,可能得到不同的数值结果。即使统一了随机种子、编译器及其他软件因素,硬件层面的差异仍可能存在。要解释这种差异,就必须理解硬件内部实际执行的算术运算。
二是训练精度。GPU 浮点计算采用的内部精度可能不同于标准浮点运算,这种精度差异会影响 LLMs 的训练。例如,有研究者曾报告,Hopper GPU 的 FP8 矩阵乘法内部精度不足,会导致 LLMs 训练精度下降。
这两个问题指向同一个根源——业界对硬件数值行为缺乏白盒层面的理解。没有这个基础,我们就只能在LLMs系统出现问题后依赖经验被动应对,难以事先进行数值分析、精度预测、问题诊断、设计有理论依据的缓解措施。
直击矩阵运算的“黑盒”:MMA 单元
为解决这一问题,研究员们把目光投向了 GPU 矩阵乘累加(matrix multiply-accumulate,MMA)单元的数值行为。矩阵乘法是 LLMs 训练和推理中线性代数运算的核心,GPU 中的专用单元负责计算D=A×B+C形式的运算。NVIDIA 将这些单元称为张量核心(Tensor Core),AMD 则称其为矩阵核心(Matrix Core)。它们支持 LLMs 所用的浮点数据类型,同时提供高吞吐量和高效率。
问题在于,暴露给软件的MMA指令规定了运算的数学定义D=A×B+C,却没有规定其数值实现方式。计算结果取决于融合粒度、内部精度、舍入与规格化、次正规数处理、求和顺序,以及其他实现细节。这些隐藏的算术选择决定了 D 中实际计算出的数值,并最终影响可复现性、精度和稳定性。
研究员们的目标是通过白盒模型,将底层计算过程明确地描述出来。通过采用特征探测测试(feature-probing test),来构建这些模型。
一道算术题,六种答案
先看一个具体的 MMA 运算示例。图1中高亮显示的 A 的第一行、B 的第一列,以及 C 的第一个元素,共同决定了 D 的第一个输出元素。考虑以下输入对 (−213,210), (−0.5,1), (−0.25,1), (−0.125,1),以及值为223的累加输入。
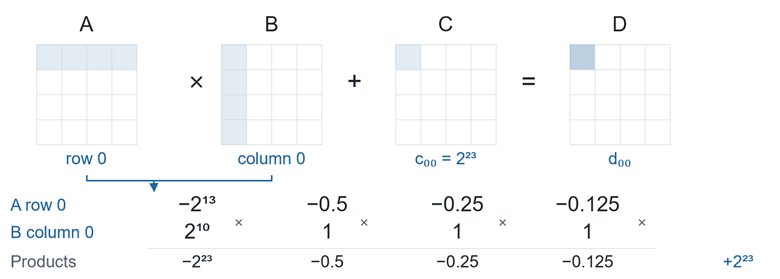
各对输入相乘后,得到 −223、−0.5、−0.25和 −0.125。从数学上看,将这些乘积加到累加器 223上,结果应为 −0.875。
那么各条硬件指令实际会返回什么?面对完全相同的输入,如图2所示的 MMA 指令产生了六种不同的结果:0、−0.375、−0.5、−0.75、−0.875(精确结果)以及 −1。
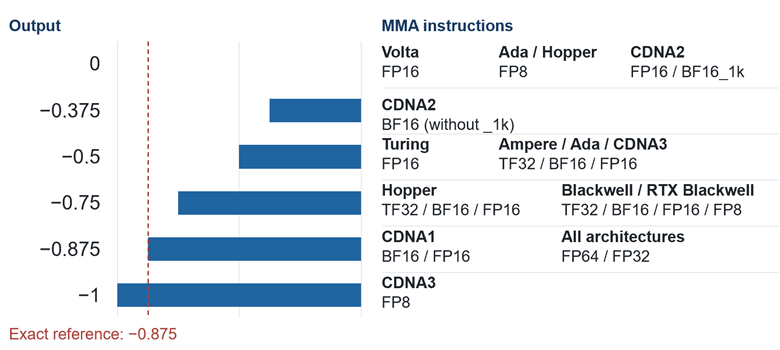
这个例子清晰地展示了隐藏算术选择的影响。研究员们要构建的模型,既要逐比特复现每条指令的结果,也要能解释这些输出是如何产生的。
从这些输出反推硬件内部计算方式的方法,称为特征探测测试。下面举两个例子。
第一,探测求和顺序。仍然使用与前例相同的加数,对比两棵求和树(如图3所示),以展示求和顺序如何影响结果。图3左侧的加法运算构成了一条顺序执行的链,累加器 C 从一开始就参与其中。在顺序求和中,两个大数首先抵消,其余加数得以保留,最终得到(((223−223)−0.5)−0.25)−0.125=−0.875。右侧则先将乘积两两相加,再将这些和与 C 累加。在本例采用的有限精度算术下,成对求和时,较小的项在与较大的项相加时丢失,最终得到223+((−223−0.5)+(−0.25−0.125))=0。
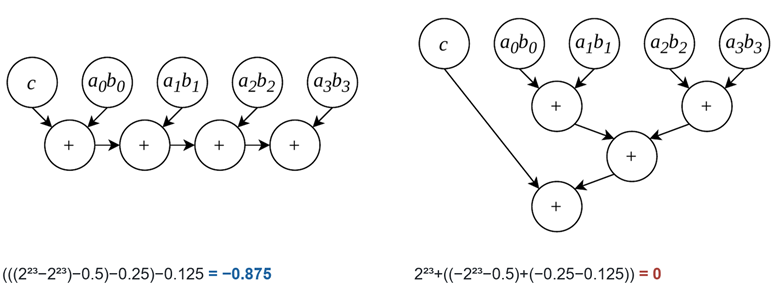
推广开来,可以选择一个大数 U 和一个小数 v,使得 U+v 舍入后仍为 U。随后再加上 −U,结果就是0。如果先让 U 与−U 抵消,则 v 会被保留下来。通过将大数放在不同的输入位置,并观察哪些小数项能够保留,就可以推断出求和的顺序。
第二,探测内部精度和舍入模式。仅靠求和顺序还不足以完整解释这些结果,研究员们设计了一个包含五个加数的融合运算:将 U 和 −U 放在求和树的两个叶节点上,其余三个叶节点均放置 v。如果内部精度足够高,运算会保留全部三个小数项,并返回 3v。但有限精度的融合运算可能在抵消发生前的对齐阶段就丢弃了这些小数项,从而返回 0。
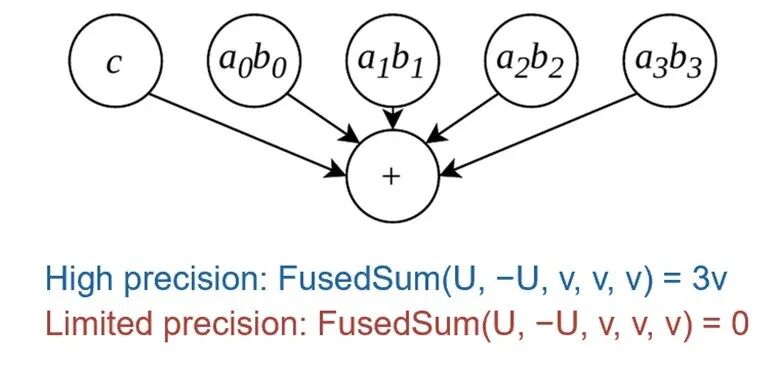
计算 U、−U和ϵ 的融合求和,从ϵ=0.5U 开始,反复将其减半。ϵ 不再被保留时所对应的阈值,可以揭示内部小数位的位数。进一步在该阈值的一半处,以及略高于和略低于该值的位置测试ϵ,还可以推断出舍入模式。
以上只是特征探测测试中的几个例子。研究员们把完整的建模方法称为闭环特征探测(closed-loop feature probing,CLFP)。只要能够通过接口调用某条 MMA 指令,CLFP 就可以利用一组不断扩充的特征探测测试,构建可执行的算术模型。
整个流程分为五步:
- 检查确定性假设,以及不同输出位置之间的一致性假设。
- 推断求和树及其元数,即各求和节点包含的输入数量。
- 探测其他算术特征并构建模型。
- 通过随机差分测试,逐比特比较硬件输出与模型输出。
- 如果验证失败,第五步就会对反例进行缩减,向探测测试集中加入一个能够区分不同行为的测试,修订模型,然后返回第4步。
这个反馈循环能够发现先前探测遗漏的细节,并将每一次不匹配转化为新的特征探测测试。当模型在验证测试中能够逐比特匹配硬件时,循环结束。
十种架构,三大模型族:MMA-Sim 的位精确模型
研究员们将 CLFP 方法应用在了十种 GPU 架构上的全部浮点 MMA 指令,包括NVIDIA 的 Volta、Turing、Ampere、Ada Lovelace、Hopper、Blackwell 和RTX Blackwell,以及 AMD 的 CDNA1、CDNA2和 CDNA3。覆盖的格式有 FP64、FP32、TF32、BF16、FP16、FP8、FP6、FP4、MXFP8、MXFP6、MXFP4和 NVFP4。这样广泛的覆盖范围展示了该方法的通用性,也让跨代比较各架构的数值行为成为可能。
研究员们从这些架构中归纳出了三大模型族:
- FTZ-MulAdd 模型采用独立的乘法和加法运算,并具有次规格数归零(flush-to-zero)行为。
- FMA 模型采用一系列融合乘加运算。
- FDPA 模型族则包含六种融合点积加法运算变体。
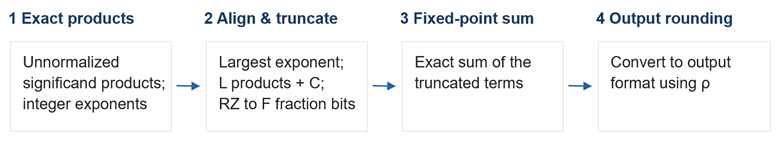
截断型 FDPA(T-FDPA)是其中最简单的一种 FDPA 变体,能够为 NVIDIA GPU 上的大多数 MMA 指令建模。它的计算过程是,先计算精确的、未经规格化的乘积;再把 L 个乘积和累加器都对齐到它们中的最大指数,然后将每个对齐后的项向零截断,保留 F 个小数位;之后使用定点算术对截断后的定点数进行精确求和;最后采用舍入模式 ρ,将结果转换为输出格式。该模型的参数包括融合长度 L、小数位数 F,以及输出舍入模式 ρ。
用这个模型回看开头的例子,通过重点观察截断操作可以发现,抵消发生前的截断决定了哪些小数项能在最终结果中保留下来。当 F=23 时,三个小数项在两个大数抵消之前就全部丢失,因此结果为零。当 F=24 时,−0.5 得以保留,结果为 −0.5。当 F=25 时,−0.5 和−0.25 得以保留,结果为 −0.75。精确的融合求和则会保留全部三个小数项,得到 −0.875。
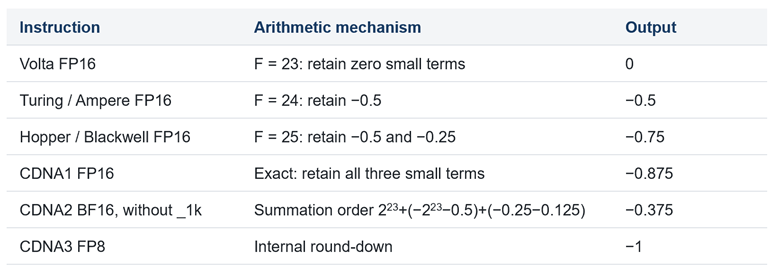
其他架构需要不同的模型来描述。例如,CDNA2 GPU 上不带 1k 后缀的 BF16 MMA 指令由 FTZ-MulAdd 模型描述,对于求和顺序223+(−223−0.5)+(−0.25−0.125),模型中的有限精度运算可以得到 −0.375。CDNA3 GPU 上的 FP8 MMA 指令则由 GTR-FDPA 模型描述,其中中间结果向下舍入为 −1.0。至此,开头的六种答案都得到了解释。
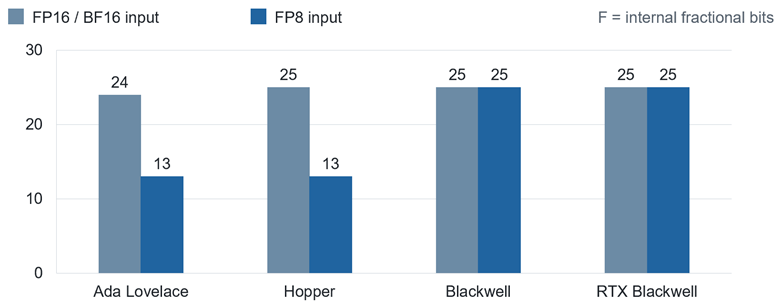
推断出的参数还清楚地反映了 GPU 的代际演进。这里,F 表示内部定点求和的小数位数。对于输出为 FP32 的指令,Ada Lovelace GPU 在输入为 FP16 和 BF16 时采用 F=24,而在输入为 FP8 时采用 F=13。Hopper GPU 对应的取值分别为 F=25 和 F=13。Blackwell和 RTX Blackwell GPU 将 FP8 输入路径的 F 提高到了 25,与其 FP16 和BF16 路径一致。这是内部精度得到提升的一个具体例证。
精度去哪儿了?四大瓶颈与一个“负向偏差”
利用这些模型,研究员们发现了计算流水线中四个不同阶段的精度瓶颈。
- 第一个是输入处理:CDNA2 GPU 上的 FP16 MMA 指令会将次正规数输入归零,使其贡献在乘法发生之前就丢失。
- 第二个是内部求和:Ada Lovelace 和Hopper GPU 上的 FP8 MMA 指令保留 F=13 个小数位,这决定了对齐后有多少信息能够保留下来。
- 第三个是输出舍入:Ada Lovelace 和Hopper GPU 上输出为 FP32 的 FP8 MMA 指令,会将结果舍入至 E8M13 精度。
- 第四个是最终输出格式:NVIDIA GPU 上输出为 FP16 的MMA 指令,即使内部计算采用 FP32 级别的精度,也会将结果舍入为 FP16。
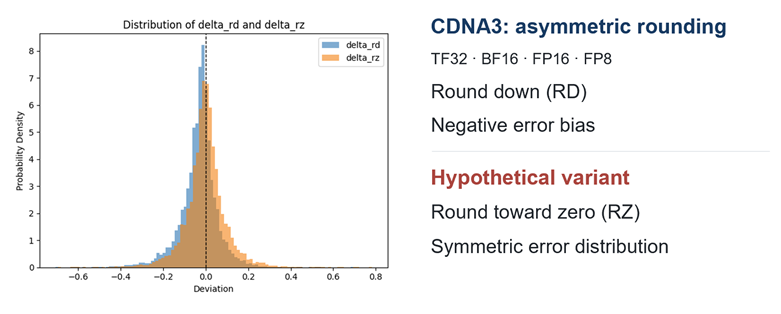
这些瓶颈降低了 MMA 指令的数值精度。另一个值得关注的问题是 CDNA3 GPU 上潜在的数值偏差。CDNA3 GPU 上输入为 TF32、BF16、FP16或 FP8 的 MMA 指令,内部采用向负无穷方向舍入这种非对称模式,可能引入负向偏差,并在重复运算中不断累积。
研究员们把实际的 FP16 MMA 指令与一个采用对称向零舍入的假设变体做了比较。结果显示,相对于高精度参考结果,假设变体的误差分布是对称的,实际指令产生的分布则整体向负值方向偏移。
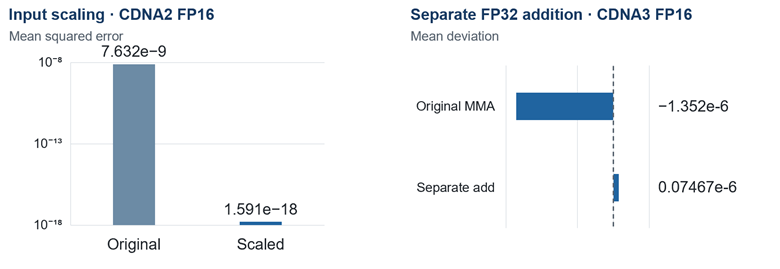
针对上述机制,研究员们提出了软件层面的规避方案。下面是两个例子。第一种方案先放大输入,使次正规数进入正规数范围,再对输出进行反向缩放以补偿。对于 CDNA2 GPU 上的 FP16 MMA 指令,这使相对于参考结果的均方误差(MSE)从 7.632×10⁻⁹降至 1.591×10⁻¹⁸。第二种方案将 MMA 累加器 C 设为零来计算 A×B,然后使用 FP32 单独加上原始的 C。这减轻了 CDNA3 非对称舍入的影响,使平均误差的绝对值降至原来的约 1/18。
软件方案能够缓解症状,但硬件设计才能解决根本原因。因此,研究员们对未来的 MMA 单元设计提出了三点建议:
- 首先,在整个计算流水线中保持 FP32 级别的精度。
- 其次,优先采用对称的内部舍入模式,以避免方向性偏差;对于原码表示或反码表示,向零舍入也可能具有较高的实现效率。
- 最后,利用可执行模型开展持续的数值测试,并在设计探索中纳入精度考量。明确的算术语义有助于评估硬件设计中的权衡,并选择有针对性的软件缓解措施。
从“黑盒”到“白盒”:让每一个比特都有据可查
CLFP通过探测、建模与验证构成的闭环流程,揭示了隐藏的算术行为。借助由此得到的白盒模型,MMA-Sim 能够在十种 GPU 架构上逐比特复现所测试 MMA 指令的输出,解释数值差异,并指导精度改进。
研究员们希望,这项工作能让 GPU 的数值行为从“黑盒”变成“白盒”,为大模型的可复现性、训练稳定性和下一代 AI 硬件设计打下更扎实的基础。
Bit-Accurate Modeling of GPU Matrix Multiply-Accumulate Units: Demystifying Numerical Discrepancy and Accuracy (MICRO 2026)
论文链接:https://arxiv.org/abs/2511.10909 (opens in new tab)
开源链接:https://github.com/microsoft/MMA-Sim (opens in new tab)
 Artificial intelligence