
随着大语言模型能力的不断提升,AI 智能体(AI agent)正在从独立解决问题,走向多个智能体并行协作。然而,当智能体数量增长到几十个、几百个,乃至上千个时,如何高效组织协作,成为多智能体系统面临的重要挑战。
近日,微软亚洲研究院的研究员们提出了自组织多智能体框架 Agensh,探索了一种去中心化的规模化协作方式。Agensh 能够让多个智能体通过轻量级共享基础设施,自主发现任务、分配工作、协调依赖并整合成果。研究员们将协作规模从1 个扩展至了 1,024 个智能体,并在从零重建的大型软件系统的挑战性任务中验证了这一方法。
这项研究展示了一种新的可能性:除了提升单个模型的能力,通过扩大智能体组织的规模,也可以提升整个系统解决复杂问题的能力。
为什么多智能体系统需要新的组织方式?
近年来,AI 智能体在软件开发、复杂推理和自动化研究等领域都展现出了广泛的潜力。相比单个智能体,多智能体系统可以让多个工作单元并行执行任务,从而缩短复杂任务的完成时间。但增加智能体数量,并不意味着系统能力一定随之增长。一个关键问题是,谁来组织这些智能体?
目前,许多多智能体框架会采用“中心调度者-工作智能体”(orchestrator-worker)结构。在这种模式下,一个中心智能体负责分析目标、拆分子任务、将工作分配给其他智能体,并最终整合执行结果。
这种方式能够有效支持一定规模的并行协作,但当智能体数量持续增加时,中心调度者也面临越来越大的压力。它不仅需要理解整体任务,还必须跟踪大量智能体的执行状态、协调彼此的依赖关系,并处理可能出现的冲突。随着组织规模的扩大,中心调度者本身可能就会成为整个系统的瓶颈。
这促使研究员们思考,是否可以不再依赖一个中心智能体负责所有任务分配,而是让智能体自主组织协作?
现实中的大型软件项目提供了一个启发。在成熟的开源社区中,开发者通常不需要等待同一个负责人逐一分配工作。他们可以自主认领任务,通过共享代码仓库了解项目进展,借助消息沟通解决冲突,并通过代码评审与合并持续推进项目。Agensh 希望将类似的组织方式引入AI 智能体系统。
Agensh:让每个智能体自主参与协作
Agensh 的核心思路是,将协作组织能力从单一中心调度者转移到每个工作智能体,通过共享基础设施连接各自的工作。在 Agensh 中,每个智能体都遵循相同的协作循环,同时独立、异步地推进任务。
具体而言,智能体会先读取整体目标、已有成果以及其他智能体的最新进展,判断还有哪些工作需要完成。随后,它会自主选择有价值的子任务,并向组织声明自己的工作范围。如果发现与其他智能体的工作重叠,则可以直接沟通协调。完成任务后,智能体需要验证结果是否符合预期,再将经过验证的工作合并到共享工作空间中。之后,它将重新获取最新上下文,寻找下一项工作。
整个过程无需等待所有智能体同步,也不需要中心调度者持续安排每一步。每个智能体既是任务的执行者,也是组织协作的参与者。
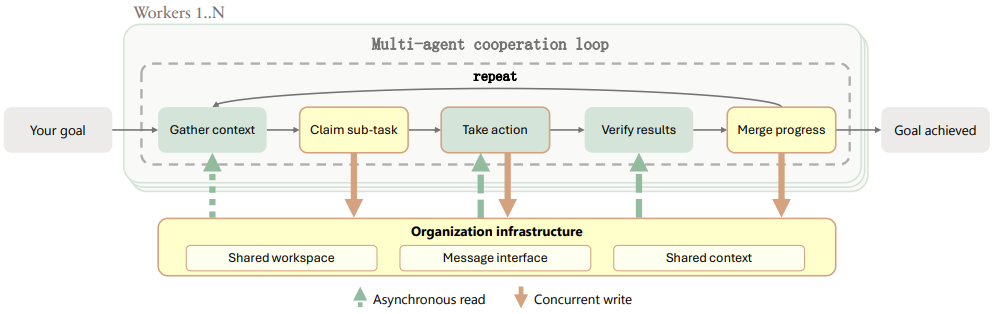
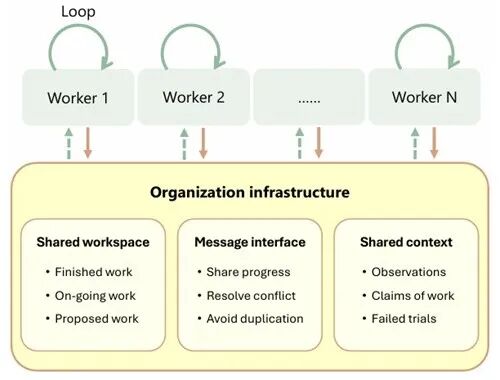
而这一协作过程主要依托三类共享基础设施展开,这三个组件分别解决了工作如何共享、成员如何沟通、知识如何积累的问题:
共享工作空间记录整个组织正在进行和已经完成的工作。不同智能体可以在独立分支中开发,通过版本管理、代码评审和合并机制,将各自成果逐步整合为共同的项目。Agensh 使用基于 Git 的工作空间,在实际实现中采用 Gitea 管理代码和协作流程。
2. 消息接口(Message Interface)
消息接口支持智能体之间的异步交流。例如,当两个智能体准备修改同一模块时,可以主动沟通以避免重复工作;当某项任务需要其他模块配合时,也可以直接联系相关智能体解决依赖。系统既支持面向组织的消息,也支持紧急的一对一通信。
除了代码与消息,智能体还需要共享在探索过程中积累的知识。例如,某个智能体发现了参考程序的特殊行为,或者验证某种实现思路不可行,这些信息都可能帮助其他智能体减少重复探索。Agensh 通过结构化共享记录保存观察结果、已验证事实、失败尝试、任务认领信息和代码修改摘要,使知识能够在组织中持续复用。
值得注意的是,Agensh 并不需要重新设计每个智能体的底层执行框架。它在现有的单智能体框架上实现了组织层,可以将智能体自身的推理和工具执行能力,与多智能体协作机制结合起来。在实验中,研究员们采用了Copilot 作为底层单智能体框架,通过统一的协作协议组织所有工作智能体。
从 1 个到1,024 个智能体:规模化协作效果如何?
为了验证 Agensh 的规模化能力,研究员们选择了ProgramBench 中最具挑战性的五项任务。ProgramBench 要求智能体在无法访问互联网和目标程序源代码的情况下,仅通过观察参考程序的运行行为,从零重建具备相同行为的软件系统。这些任务在需要大量代码实现的同时,还涉及复杂的功能分析、模块划分、测试验证和代码集成,对长时间、多智能体协作提出了很高的要求。
五项任务分别涉及多媒体处理软件 FFmpeg、分子动力学模拟软件gromacs、文档转换工具 pandoc、PHP 语言运行系统以及代码索引工具 ctags。五个项目的参考代码库均包括上千份文件、百万字节的代码。
智能体数量增加,最终表现持续改善
研究员们使用相同的 GPT-5.6-sol(high)模型、相同的底层单智能体框架和协作协议,在 6 小时的任务时间预算下比较不同组织规模。
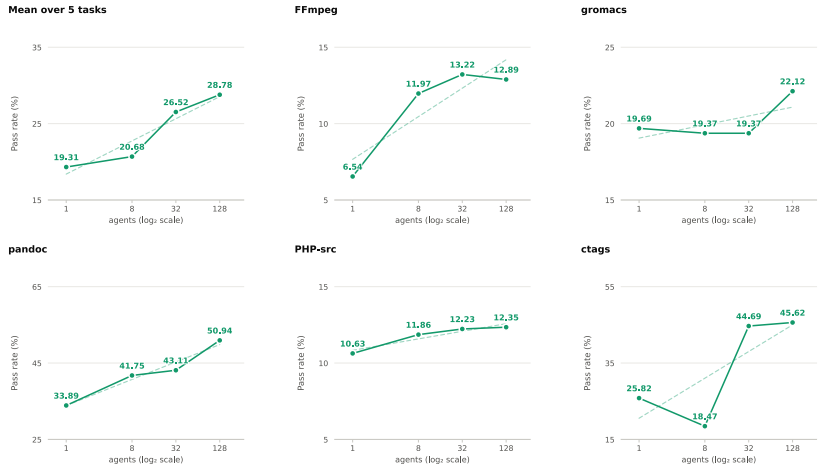
在五项任务上,平均最终测试通过率随智能体规模增长而提升。从 1 个扩展至 128 个智能体,平均最终测试通过率由 19.31% 提升至 28.78%,提高了 9.47 个百分点,相当于约 49% 的相对提升。
这说明,在底层模型不变的情况下,仅通过扩大协作规模,就有可能进一步提升系统完成复杂任务的能力。
更多智能体,也意味着更快取得进展
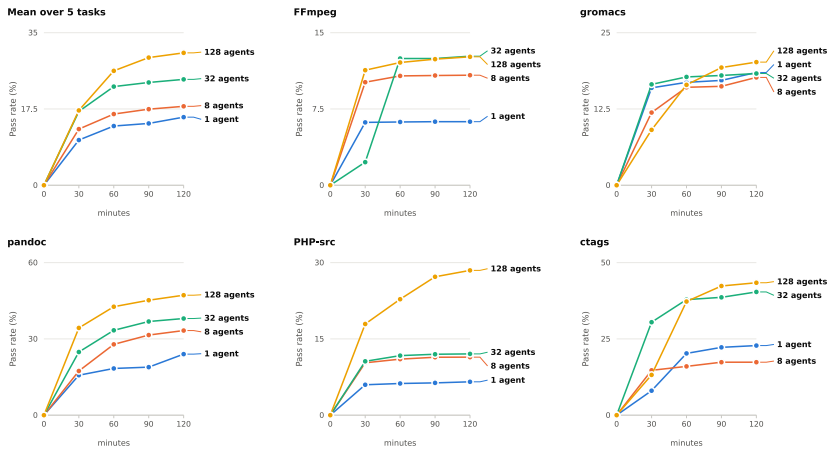
除了最终完成质量,研究员们还关注多智能体系统达到相同任务表现所需的时间。以 pandoc 为例:128 个智能体在第 30 分钟检查点时,测试通过率已经超过 30%;32 个智能体首次达到这一水平是在第 60 分钟检查点,8 个智能体则是在第 90 分钟。相比之下,单智能体在前两小时内尚未达到这一水平。
这一结果表明,规模化并行协作既有助于提升最终表现,还能缩短达到一定任务完成度所需的时间。
进一步扩展到 1,024 个智能体
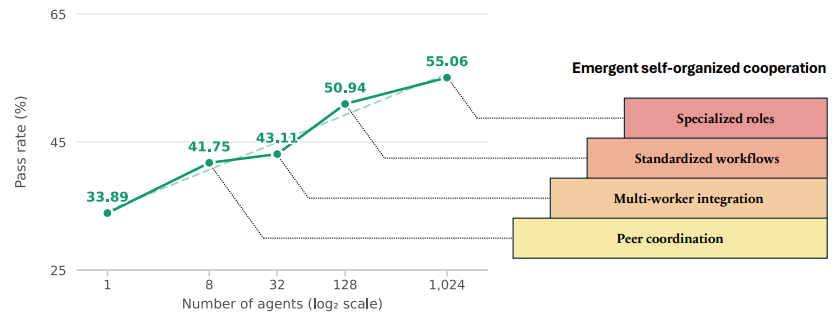
研究员们随后在 pandoc 任务上,将组织规模进一步扩大至1,024 个智能体。在相同的 6 小时任务时间预算下,最终测试通过率达到:
- 1 个智能体:33.89%
- 128 个智能体:50.94%
- 1,024 个智能体:55.06%
与单智能体相比,1,024 个智能体的最终测试通过率提高了21.17 个百分点,相对提升约 62%。
1,024个智能体的实验验证了 Agensh 在单项复杂软件重建任务上的大规模协作能力。同时,研究也表明,随着组织规模增加,性能提升并不是线性的。如何平衡协作收益、并发资源开销与协调成本,仍然是值得进一步研究的问题。
协作能力随组织规模涌现
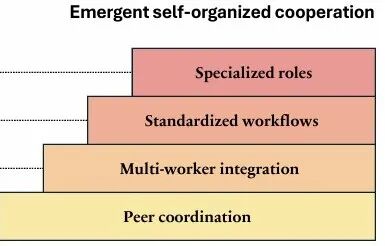
Agensh 研究中的另一个重要发现,来自大量智能体的实际执行轨迹。在所有实验中,工作智能体遵循相同的协作循环,接收的提示词也完全相同,唯一差别是各自的编号。然而,随着智能体数量增加,研究员们观察到了不同复杂程度的组织协作行为。
8 个智能体:从独立工作走向协商
当组织中有 8 个智能体时,成员开始自主协商技术接口,并按照约定并行实现不同模块。
例如,在 gromacs 任务中,智能体之间先约定模块接口,再分别完成符合接口规范的组件。在FFmpeg 任务中,当两个智能体发现任务范围出现重叠时,其中一个会主动调整工作内容,转而承担互补任务。
这种协调无需中心调度者介入。
32 个智能体:形成多人参与的集成与评审
当组织扩展到 32 个智能体时,协作开始超越简单的任务分工。
在 PHP-src 任务中,多个智能体共同参与一项代码贡献的评审。最初,部分成员认可了修改方案,但另一位成员发现具体反例,促使先前的认可被撤回。代码作者随后修复问题,其他智能体重新审查,最终由一位同伴完成合并。
在这个过程中,代码实现、问题发现、修改验证和最终集成由多个智能体共同完成。
128 个智能体:自发建立并复用标准化工作流程
当组织进一步扩大至 128 个智能体时,智能体不仅能够协作执行任务,还开始协商和复用工作流程。
例如,在 pandoc 任务中,智能体之间建立了一套集成协议:代码作者完成修改和测试后,将提交记录交给另一位智能体进行验证与合并。这一流程随后被其他成员复用。
当原有流程遇到问题时,智能体还会主动讨论并调整协议,允许负责集成的成员承担更新、测试、检查和合并的完整过程。
这些规则并非预先由系统硬编码,而是在实际协作中逐步形成。
1,024 个智能体:出现规模化的角色分工
在 1,024 个智能体的组织中,研究员们进一步观察到了专门化的角色分工。部分智能体开始承担代码集成者的职责,其他成员可以根据需求向他们请求协助。
在 pandoc 任务中,一个智能体能够同时联系多位候选集成者,选择首位有效响应者,取消其他请求,再将待集成工作交给被选中的成员。当某个集成者执行失败时,具备相似职责的其他成员还能够接管工作。这使得组织不必完全依赖某一个智能体完成关键任务。
从 8 个智能体的同伴协调,到 32 个智能体的多人集成,再到 128 个智能体的流程标准化,以及 1,024 个智能体的角色专门化,Agensh 展现出了一种值得关注的现象:即使所有智能体遵循相同的基础协作协议,随着组织规模扩大,也可能自发形成更加复杂的协作方式。而这些发现来自具体执行轨迹中的代表性案例,展示了大规模智能体组织的潜在协作能力。
AI agent 的新 scaling 维度
过去,大模型能力的提升主要依靠模型参数、训练数据与计算量的扩展。进入 AI 智能体时代,智能体数量与组织协作方式,也成为值得探索的 scaling 维度。
Agensh 提供了一种不同于中心调度模式的系统设计思路:不要求一个智能体掌握全部任务和成员状态,而是让每个成员基于共享信息主动发现工作、协调依赖并交付成果。更重要的是,这种协作方式能够建立在现有单智能体框架之上,使模型推理能力和组织协作能力可以相互补充。
当然,现阶段的研究主要聚焦于复杂软件的重建任务,1,024个智能体规模的验证也集中在pandoc 这一任务上。如何将自组织机制推广至更多任务场景,以及如何在更大规模下进一步优化资源效率和协作成本,仍有广阔的研究空间。
然而,Agensh已经展示出了一个有意义的方向:多智能体系统的规模化,不仅是增加并行工作的智能体数量,更是让这些智能体能够有效地组织起来,共同推进复杂目标。从单个智能体的独立执行,到上千个智能体的自主协作,Agensh尝试探索 一条AI 系统能力扩展的新路径——通过自组织协作,将个体能力转化为组织能力。
Agensh: Scaling Organizational Intelligence to 1,024 Agents
论文链接:https://arxiv.org/abs/2609.26781 (opens in new tab)
 Artificial intelligence